OCR 分數之外:文件 parser 真正失敗的地方
2026年10月4日
用 1,250 頁沒有調校過的 held-out 頁面,把十二個 Reader 各自用作者自己的協定跑一遍:MinerU2.5-Pro + dots.mocr 的 composite、OCR 專用模型、open-weights VLM、兩個雲端 frontier 模型,以及每台 Mac 內建的免費 OCR。重點不是誰的平均分數漂亮,而是你的系統會在哪些頁面上直接失去資料。
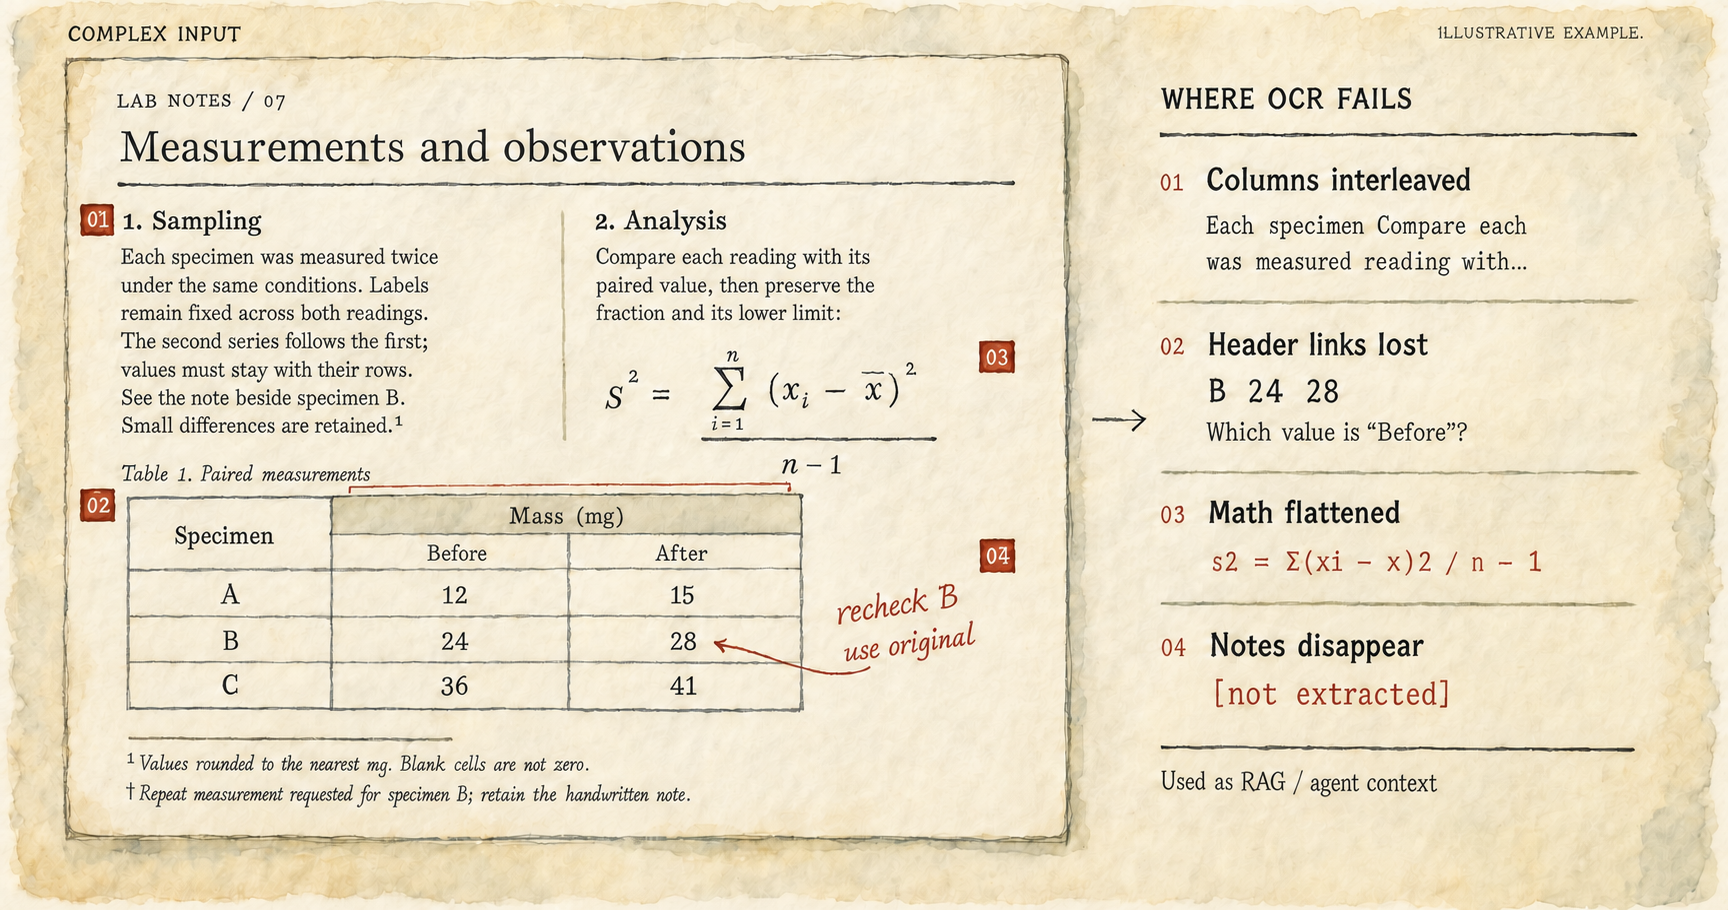
OCR 失敗的幾種樣子:欄位交錯、表頭消失、數學被壓平、註解被省略,一頁複雜的版面在進到 RAG 或 AI agent 之前就已經走樣。
每個文件系統都有那麼一刻,必須把一頁紙變成機器能用的文字:真實的紙,掃描、拍照或匯出,帶著欄位、註腳和糊掉的表格。這一步的品質,後面每一層都會照單全收:retrieval 找不到一個 parser 從沒產出的段落,agent 也無法對一團爛泥般的表格做推理。我自己是在 Apple silicon 的 Mac 上做這件事,而這裡選擇多到有點奢侈:兩段式文件 parser、單一模型 OCR 專家、通用 vision-language model(本機 open-weights 或雲端 API),還有作業系統自己內建的文字辨識。所以問題就變成:今天所有能讀一頁紙的東西裡,包括每台 Mac 裡免費附贈的那個 OCR,到底該用哪一個?
這篇文章就是那個比較,而且照我希望別人也這樣跑的方式做:一個 benchmark、一份沒有調校過的 held-out 頁面、每個 Reader 都跑它作者自己出的協定、用 benchmark 官方 evaluator 評分,然後把失敗拆到夠細,細到你能看出哪些頁會在哪個 Reader 手上丟掉。
它只量準確度,其他一概不量。速度、價格、硬體需求當然都是真限制,但那是簡單的那一半:從外面就看得到,而且下一代晶片或下一張價目表就會改寫。一個 Reader 在你的頁面上讀錯什麼不會改寫,而且那是唯一會一路沉進 index、繼續餵給後面每一個答案的東西。
Reader 在 RAG 或 agent 系統裡的位置
OCR 狹義上是把像素變成字元的那一步。這篇文章講比較寬的那一層:找出頁面上的區塊、決定它們的閱讀順序,再把每一塊轉成機器能吃的東西:文字就是文字,表格就是表格,公式就是公式。這裡每一個 Reader 都照整份工作來量,所以文章講 Reader,而不是 OCR engine。
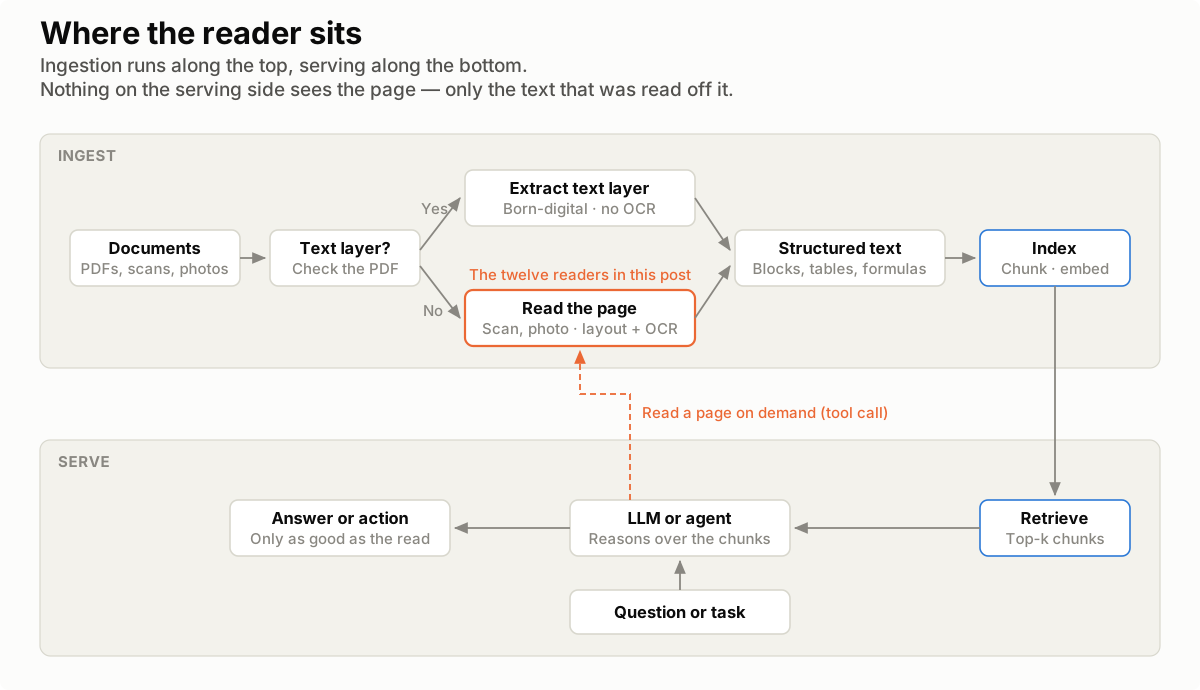
圖一畫出這一步落在哪裡。文件以 PDF、掃描檔和照片進來,Reader 把每一頁變成結構化文字,文字被切成 chunk、做 embedding、進 index;查詢時從 index 取回,再交給模型推理。關鍵是:serving 這一側永遠看不到原本那一頁,只看得到 Reader 說了什麼。被 Reader 漏掉的段落不難找,是不存在;變成一串文字的表格沒辦法篩選也沒辦法加總。而且整個過程不會報錯:embedding 模型照樣能把爛泥 embed 起來,vector store 照樣會用一個很有自信的分數把它還給你。Agent 讓兩邊都更尖銳:它是在任務中途自己去讀,沒有人在旁邊瞄一眼輸出;它又會照讀到的東西行動,所以掃描發票上被默默吃掉的一欄,結果就不是一句話錯了,而是一個動作做錯。
Reader 是整個系統的根本,之後的每一步都補不回來。 更強的 embedding 模型、reranker、更長 context window、更好 LLM,它們全都只作用在 Reader 的輸出上,沒有一個看得到原本那一頁。OCR 讀錯的數字不是「比較難推理」,它根本就是另一個數字,而推理能力很好的模型,只會很有條理地推向錯的答案。這一步的錯誤不會往下游衰減,只會被放大,因為後面每一站都把手上的文字當成事實。壞 Reader 唯一的解,是換一個更好的 Reader。
在開始量之前先分一個岔。born-digital 的 PDF 自己就帶著 text layer,抽出來是確定性、幾乎免費而且逐字精確,所以一條蓋得好的 pipeline 會先檢查有沒有這層,只有在非送不可的時候才把像素交給 Reader。這篇文章刻意站在像素這一邊:研究裡每一頁都是以圖片進來的,所以這些數字描述的,是 text layer 不存在或不可信時,pipeline 會走的那條分支。
benchmark
所有數字都量在 OmniDocBench(Ouyang et al., CVPR 2025)上,它是整頁文件解析裡標註最講究的公開 benchmark。1.6 版收了 1,651 頁真實 PDF,而且是逐塊標註:每個文字區塊、每個表格 cell、每條公式、每條閱讀順序的邊,都是人工標的。它還有一個很有用的性格:刻意偏向會讓 parser 出事的頁面:密到不行的中日韓報紙、考卷、手寫筆記,而不是每個方法看起來都差不多的乾淨單欄 PDF。十種來源從掃描書籍(212 頁)、匯出成 PDF 的簡報(196 頁),一路到期刊論文、考卷、教科書、雜誌、對開報紙(115 頁)、財經研究報告和手寫筆記。
真正要緊的是我引用哪些頁。我把 1,651 頁切成兩半:用固定亂數種子抽出 401 頁拿來調校,剩下的 1,250 頁則沒有被拿來調校、除錯或改 prompt。這篇文章每個數字都來自那 1,250 頁,而且切分是分層抽樣,所以兩半的組成彼此相像,兩個 Reader 之間的差距才算得到 Reader 頭上,而不是算在它們剛好分到的頁面上。小樣本沒有這個性質,表格分數又最容易出事:隨手挑 64 頁,表格密度會是這個 benchmark 任一半的四倍,而算出來的表格分數會往某個方法剛好的弱點方向偏掉十幾分。
四個指標,全部來自 benchmark 自己的 evaluator:
- 文字編輯距離(越低越好):預測與 ground truth 文字區塊之間正規化後的 Levenshtein 距離,逐頁平均。這是 Reader 的主指標:0.05 代表逐字來看有 95% 是對的。
- 表格 TEDS(越高越好):Tree-Edit-Distance Similarity,同時看表格結構與內容,以百分比表示。
- 閱讀順序(越低越好):Reader 吐出文字區塊的先後,與正確順序之間的編輯距離。多欄版面就是在這裡咬人。
- 公式編輯距離(越低越好):對 display 公式做 LaTeX 正規化後的編輯距離。
TEDS 旁邊還有一個衍生數字:found-only TEDS,只算 Reader 偵測到的表格,並且跟它整張漏掉幾張表格並列。一個漏掉三分之一表格、卻把剩下的都轉寫得很漂亮的 Reader,跟一個每張都找得到、卻把 cell 攪爛的 Reader,是兩種問題,也要兩種修法。
公開排行榜報的則是單一總分,也就是式 (1),三個指標的等權平均:
第三項值得多說一句,因為它是這裡唯一不靠編輯距離的指標。CDM(Character Detection Matching,越高越好)的作法是把預測和 ground
truth 的 LaTeX 都算繪成圖,再比對圖上看得到的符號。同一個數學有很多寫法,像 \frac{a}{b} 和 \dfrac{a}{b}、x^{2} 和
x^2。編輯距離會為每個不一樣的字元記上一筆帳,CDM 只問算繪出來的公式對不對。兩者分歧的時候,代表 Reader 只是把同一個數學寫成另一種寫法;兩者一起掉下去,才是真的讀錯了數學。
我不用式 (1),因為單一數字沒辦法告訴你壞在哪裡。一個表格全找得到但 cell 全錯的 Reader、一個 cell 轉寫完美卻漏掉三分之一表格的 Reader,還有一個每塊都讀對但順序全亂的 Reader,可以拿到一樣的 Overall,而三者要修的地方完全不同。式 (1) 也整個丟掉了閱讀順序,而那正是把這些 Reader 拉得最開的指標。所以這裡欄位分開報;同樣的理由,這些數字也不是排行榜的數字,不該拿去跟它對照著看。
十二個 Reader
十二個 Reader,每一個都跑它作者自己出的協定(他們的 prompt、他們的階段、他們的防護),而且跑在同一台 Apple silicon 機器上;只有兩個雲端模型例外,它們跑在供應商自己的伺服器上。
我在 production 用的那個 Reader 最需要交代,所以先講它。兩段式 parser 會把每一塊都送進同一個辨識器,表格、公式、段落一律走同一條路,而 retrieval 的 index 裡絕大部分其實就是段落。所以我沒有直接把最強的單一 parser 端出去,而是讓 MinerU2.5-Pro 繼續負責 layout、閱讀順序、表格和公式,再把沒有公式那些頁面上的段落,交給一個除了轉寫段落什麼都不做的模型。composite 輸出的每一張表格、每一條公式,都是 MinerU2.5-Pro 原封不動的結果。
- composite(MinerU2.5-Pro + dots.mocr):我在 production 用的 Reader。MinerU2.5-Pro(OpenDataLab,1.2B)把一頁分成兩個解耦的階段來解析,先在縮小的畫面上做 layout,再在原解析度的裁切上做辨識,這也是小模型還吃得下密集頁面的原因;dots.mocr(rednote-hilab,約 3B)則是接手段落的那個專家。
- MinerU2.5-Pro 單跑:同一個 parser,但不換段落,用來看 composite 到底加了什麼。
- dots.mocr 單跑:照它作者的方式跑,整頁一次讀完,用它自己的 prompt,前面不放 layout 或表格模型。
- GLM-OCR(Z.ai,0.9B),在公開的 OmniDocBench 排行榜上是 95.22,這裡跑的是它自己的 SDK:先用 layout 模型找出區塊和順序,再逐塊問辨識器。
- PaddleOCR-VL-1.6(百度,0.9B),同一個排行榜上是 96.34,也是文件寫得最清楚「這個 VLM 不可以單獨跑」的一個。這裡就照它出貨的樣子跑,前面掛著 layout 階段。
- Unlimited-OCR,百度接續 DeepSeek-OCR 光學壓縮架構的作品,整頁一次讀完,並帶著它自己 recipe 裡的解碼防護。
- RapidOCR:32 MB 的 ONNX 權重、跑在 CPU 上,而且跑兩次:單跑一次,前面掛上 RapidAI 的 layout 和表格模型再跑一次。這是全篇最乾淨的一組對照:同一個辨識器,差別只在有沒有 layout 階段。
- LiteParse(LlamaIndex),唯一一個用規則而不是模型組起來的 Reader:Tesseract OCR,加上從文字座標重建出來的版面。
- Apple Vision,macOS 內建的文字辨識,也就是 Live Text 背後那顆引擎。有一個設定決定了它的成績:最小文字高度預設是頁高的三十二分之一,這會在辨識開始之前就默默丟掉報紙的每一欄內文,所以我把它調低了。
- Qwen 3.6(阿里巴巴,35B open weights),用 prompt 請它把整頁轉寫出來。它是每個專家模型都該打贏的對照組:什麼都學過,但對這個任務什麼都沒調過。
- Claude Fable 5.1:同一個 prompt 送到 Anthropic 的 API,thinking 關掉。
- GPT-6 Astra:同一個 prompt 再送一次,這次給 OpenAI 的 API,整頁以完整解析度進去。這兩個雲端模型回答每個團隊都會先問的那個問題:雲端 API 是不是已經比你自己跑得動的東西都好了?
結果
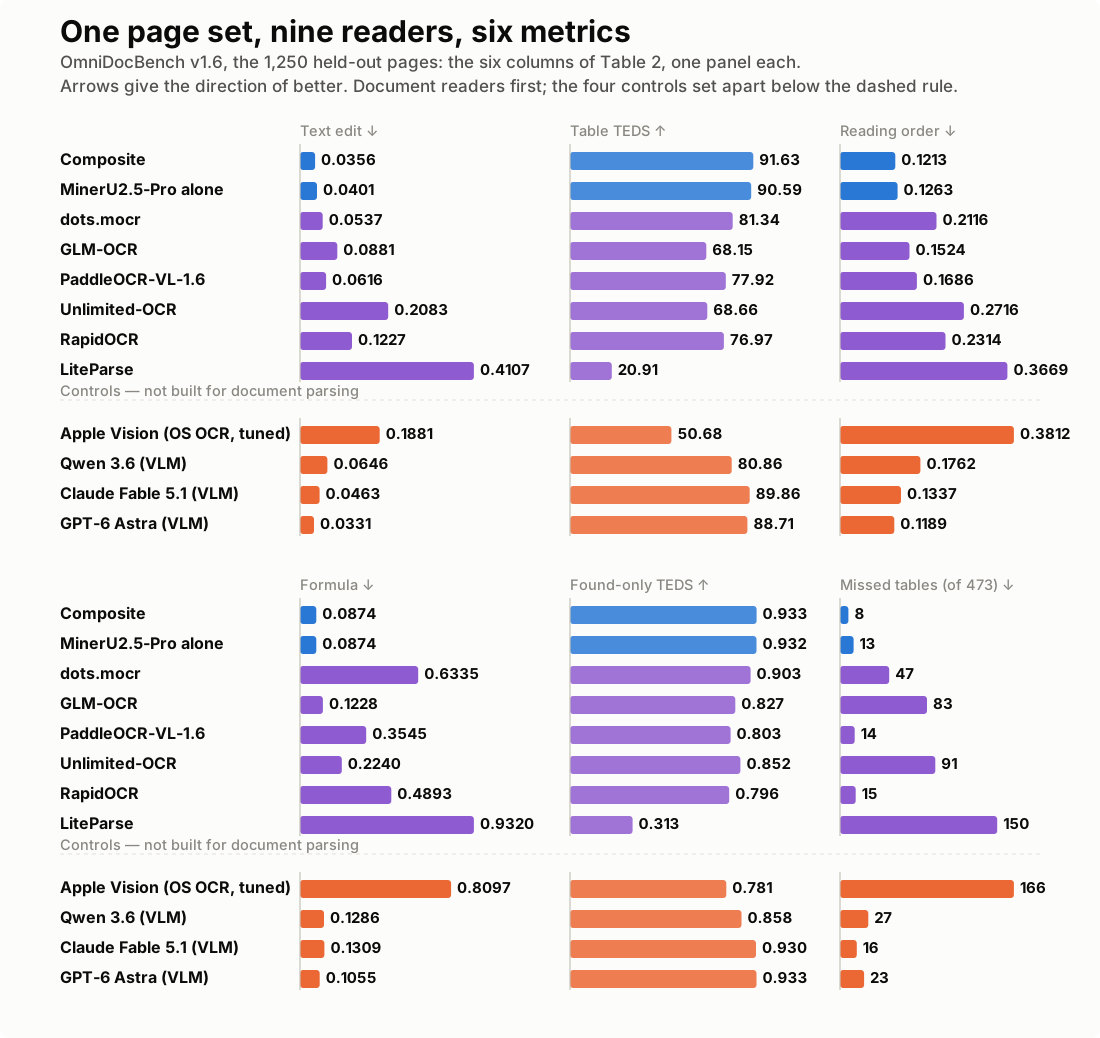
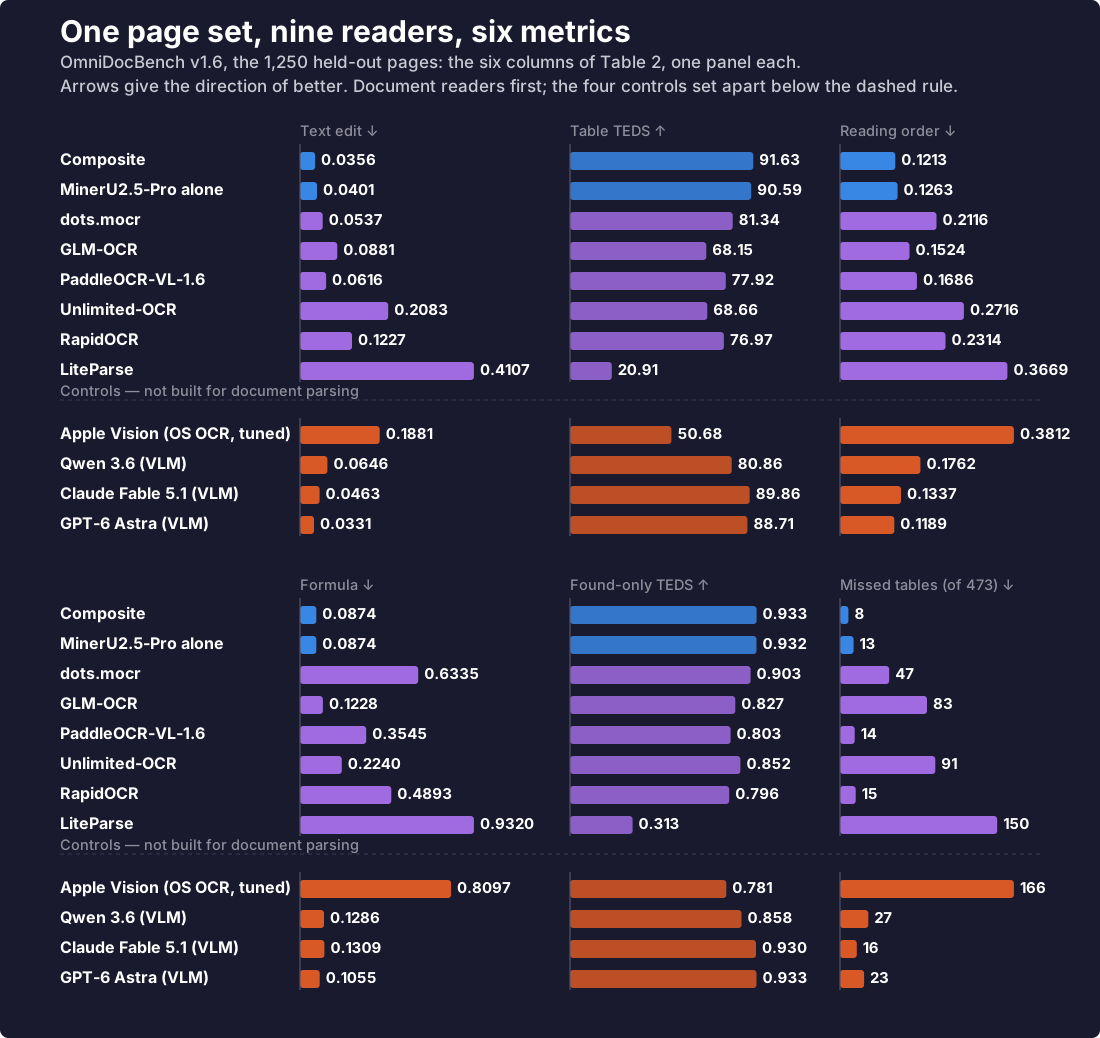
composite 是你自己跑得動的 Reader 裡最強的一個,而且沒有任何一欄輸給它內部的模型。 文字 0.0356、閱讀順序 0.1213、TEDS 91.63,473 張表格裡漏掉 8 張;MinerU2.5-Pro 單跑則是 0.0401、0.1263、90.59 和 13 張。display 公式上兩者到小數點後四位完全一樣,這是設計而非巧合:有公式的頁面原封不動交給 MinerU2.5-Pro,所以打平就是天花板,而它在全部 231 頁都打平了。讓人意外的是表格那幾欄。建在某個模型上的 pipeline,照理說找不到它漏掉的表格,所以我原本預期最好也就是打平;結果 composite 漏掉的那組是 MinerU2.5-Pro 的嚴格子集,而且還救回模型單跑時丟掉的五張。
專攻段落的那一半單跑也是個像樣的 parser,只是結構不行。 dots.mocr 整頁一次讀完,落在文字 0.0537、TEDS 81.34,473 張表格漏掉 47 張,而且沒有 layout 模型、沒有表格模型,一次前向。它的弱點是公式的 0.6335,而那是轉寫得爛,不是完全沒讀:在 231 頁有 display 公式的頁面裡,它有 225 頁真的寫了 LaTeX,只是寫錯。
中段那四個 pipeline 每一欄都輸給 composite,而且各自輸在不同地方。 GLM-OCR 是文字 0.0881、TEDS 68.15,473 張表格漏掉 83 張,而問題不在 layout 階段:偵測器 473 張裡找到了 462 張,漏掉的多半是找到之後又丟掉的,因為辨識器被要求輸出表格,有時候卻回你一段散文。PaddleOCR-VL-1.6 則是相反的形狀:文字 0.0616、TEDS 77.92,只漏掉 14 張表格,是全篇第三好,但它的公式是所有兩段式 parser 裡最差的,編輯距離 0.3545、CDM 60.34,而它自己公布 97.53。RapidOCR 讓人看清楚 layout 階段值多少:同一批 CPU 權重單跑是文字 0.4337、TEDS 0,每一張表格都漏掉;掛上 RapidAI 的 layout 階段之後變成 0.1227、TEDS 76.97,只漏掉 15 張,報紙上好了 13 倍,手寫頁面則一點差別都沒有,因為那裡本來就沒有欄位要還原。至於用規則組起來的 LiteParse,找得到欄位卻讀不出內容:文字 0.4107、TEDS 20.91、漏掉 150 張表格,但在英文三欄頁面上它讀到 0.125,而 Apple Vision 是 0.358。欄位順序可以從文字落在哪裡還原回來;辨識和表格不行。
open-weights 的通用模型落在專家和免費 OCR 之間。 Qwen 3.6 的文字 0.0646,比 MinerU2.5-Pro 單跑落後 0.025,對一個完全沒為這個任務調過的模型來說算體面;但只要牽涉到結構,差距立刻拉開:TEDS 落後十分,閱讀順序 0.18 對 0.12,明顯比較差。
Claude Fable 5.1 在它願意讀的頁面上與 composite 平起平坐,然後拒讀了十二頁。 照實際成績算是文字 0.0463、TEDS 89.86、閱讀順序 0.1337,473 張表格裡有 16 張從頭到尾沒找到。它有十二頁是空的,因為 API 在四次嘗試裡每次都拒絕:其中十頁是轉寫到一半被內容過濾切斷,最可能是那條不得逐字重現已出版文字的過濾規則;另外兩頁(一份霍亂毒素分析和一張小鼠驚厥劑量表)則是直接被拒,這跟模型 dual-use 防護一致。把那十二頁拿掉,讓每個 Reader 都只算剩下的 1,238 頁,它是文字 0.0365、TEDS 90.43、閱讀順序 0.1253,而 composite 是 0.0358、91.60、0.1223。一個會拒讀頁面的 Reader,是這裡每個本機 Reader 都沒有的失敗模式。
GPT-6 Astra 是全篇文字讀得最好的 Reader,結構則排第四。 它的文字是 0.0331、閱讀順序 0.1189,兩項都在 composite 之前,報紙更是 0.0198 對 composite 的 0.0481。結構上它排第四:TEDS 88.71,而且 473 張表格裡有 23 張從頭到尾沒找到,composite 只有 8 張,但兩者都找到的那些表格,分數一樣是 0.933,所以整個表格差距都是偵測。
文字上的領先來自解析度,不是推理。 它是用完整解析度看一整頁,而兩段式 parser 讀的是縮小 layout 階段裁下來的區塊;閱讀順序是整頁的性質,一個把整頁放在同一個 context 裡的模型從來不需要從框框把順序拼回來,這也是它版面曲線全篇最平的原因。思考在這裡沒有作用:Roboflow 的 Vision Evals 顯示它在高推理強度下的 OCR 分數比低強度還低 0.4 分,成本卻是 2.9 倍。它輸的地方,正好是 layout 模型在做事那些頁:手寫筆記 0.0812 對 composite 的 0.0530、簡報 0.0239 對 0.0125,還有表格。這一列的代價寫在最後一節:整份跑完 $154,而且這個 Reader 無法釘住、無法檢查、也無法重跑,因為那個別名沒有日期快照、沒有權重、也沒有公布精度。
一次讀完整頁的那個專家,文字比免費 OCR 還差。 Unlimited-OCR 落在文字 0.2083,輸給 Apple Vision 的 0.1881,但結構上贏得很輕鬆:TEDS 68.66 對 50.68,漏掉 91 張表格對 166 張。它的文字差距集中而不散開,1,177 頁有文字的頁面裡有 33 頁整頁報銷,Apple Vision 只有 7 頁,把那些拿掉,名次就反過來。那些頁面上發生了什麼事,是下一節的內容。
Apple Vision 的文字比最好的 Reader 差了 5 倍以上,而那個平均值藏住了真正的故事,一樣在下一節。
每個 Reader 真正失敗的地方
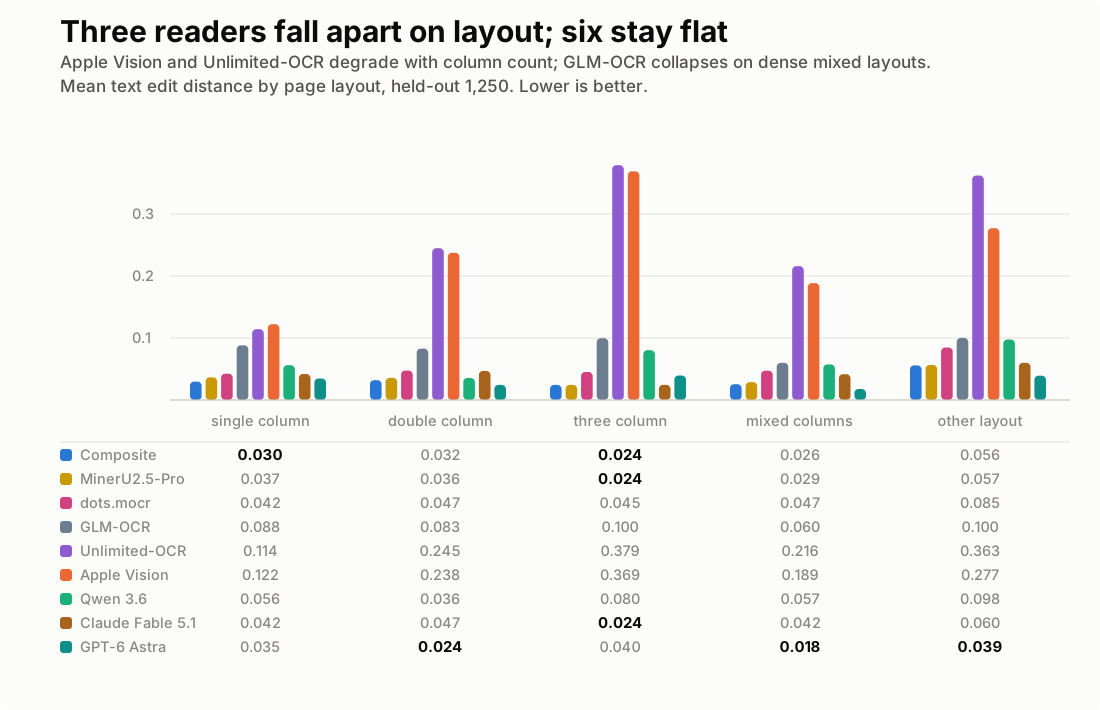
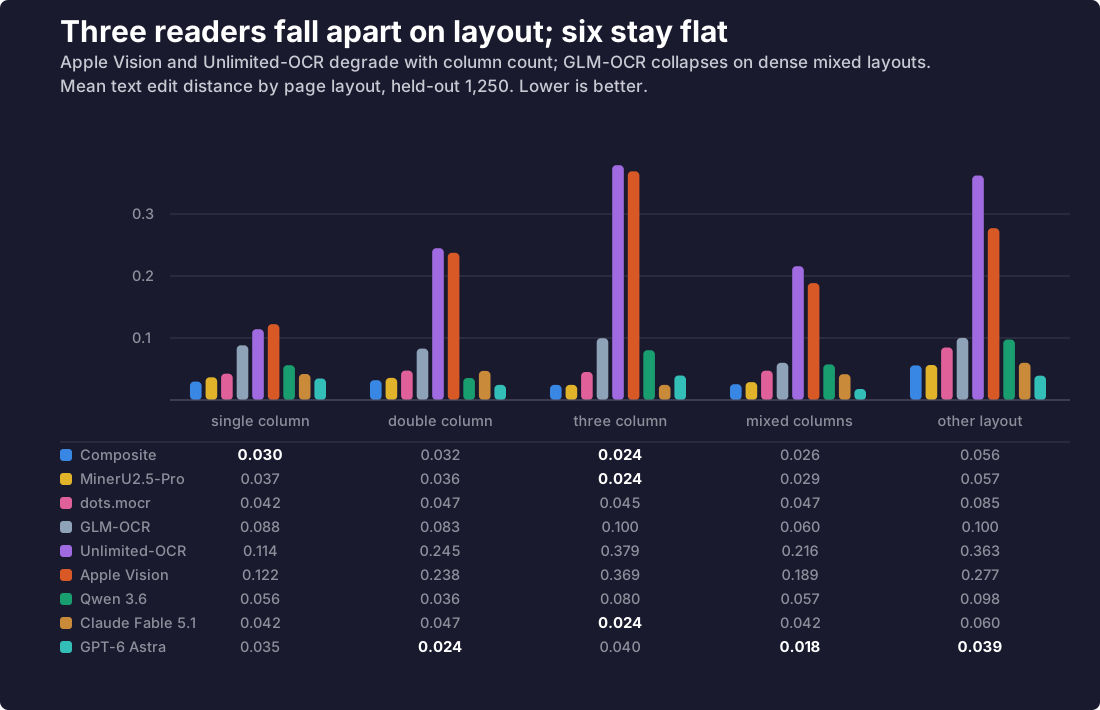
只要前面掛著 layout 階段,或者本身就是整頁讀完的 VLM,欄位變多時曲線都是平的。GPT-6 Astra 最平,每個欄位數都落在 0.024 到 0.040;composite 在三欄頁面上甚至變好;完全沒有 layout 階段的 dots.mocr 也守在 0.042 到 0.048。垮掉的是兩個,而且垮在不同的頁面上。
Apple 的缺陷是版面結構,不是字元辨識。 單欄頁面上 Apple Vision 讀到 0.122,跟兩年前的專家模型差不了多少。欄位一多就單調惡化:雙欄 0.238、三欄 0.369,而 MinerU2.5-Pro 在同一批頁面上是 0.024。Vision 字元辨識很好,只是不做版面分析。把這件事釘死的對照是 dots.mocr,它一樣沒有 layout 階段,在同一批三欄頁面上卻讀到 0.046:一個看得到整頁的模型,不必有人告訴它欄位在哪裡就能把欄位分開;而逐行辨識器只會照它找到的順序吐出每一行,在三欄頁面上,那個順序是橫著穿過三欄的。它的表格數字也是同一個簽名:找到的表格它轉寫得還可以,0.781,但 473 張裡有 166 張根本沒找到,因為表格偵測同樣是版面問題。不過在研究報告和簡報上,Apple Vision 跟最好的 Reader 只差 0.03 到 0.05,而且邊際成本是零。如果你的資料是企業文件和簡報,作業系統內建的 OCR 是個站得住腳的 parser;如果裡面有任何多欄的東西,再怎麼調都沒有用,因為那是架構層次的失敗。
Unlimited-OCR 的曲線長得跟 Apple 一樣,原因卻跟欄位完全無關。 它讀手寫筆記和書籍都比 Apple Vision 好,報紙卻掉到 0.602,是它最差的來源。輸出顯示的其實是一個放棄整頁的 decoder:1,250 頁裡有 71 頁(其中包括四分之一的報紙)輸出含有一段頁面上根本不存在的資料標註守則,而且在其中 24 頁重複了十次以上。那些頁面的成績是 0.518。報紙上,115 份輸出有 49 份長度超過 ground truth 的一點五倍,15 份不到一半:過度生成和讀不完,兩種都是整頁丟掉,不是讀錯。這是這條模型血脈在密集文字上有紀錄的行為,而它作者自己建議的補法,是給密集頁面用的分塊高解析度模式。
公式把這群 Reader 切成三層,而且層與層之間差距全篇最大。 建在 MinerU 上的兩段式 parser 是 0.0874。從整頁或逐區塊讀完再寫 LaTeX 的那些,落在 1.2 到 2.6 倍之間:GPT-6 Astra 0.1055、GLM-OCR 0.1228、Qwen 3.6 0.1286、Claude Fable 5.1 0.1309、Unlimited-OCR 0.2240。再往下是一道斷崖,而那已經不是程度差別。PaddleOCR-VL-1.6(0.3545)和 dots.mocr(0.6335)每條方程式都試著寫,然後寫錯;Apple Vision 的 0.8097 和 LiteParse 的 0.9320 則不是公式讀得爛,而是根本沒在讀:兩者都只是把眼前的字形轉寫出來,對 LaTeX 沒有概念,於是方程式回來時只是一串散開的符號,會被當成文字計分,意思卻已經沒了。光看編輯距離,分不出「寫錯」和「沒寫」,單一總分更分不出來。CDM 對照編輯距離就可以:dots.mocr 是 39.95、PaddleOCR-VL-1.6 是 60.34(它的損失有很大一部分是算繪出來一模一樣的改寫),而 composite 是 95.93。如果你的文件裡有數學,這就是整個決策,而任何一個總體文字分數都照不出來。
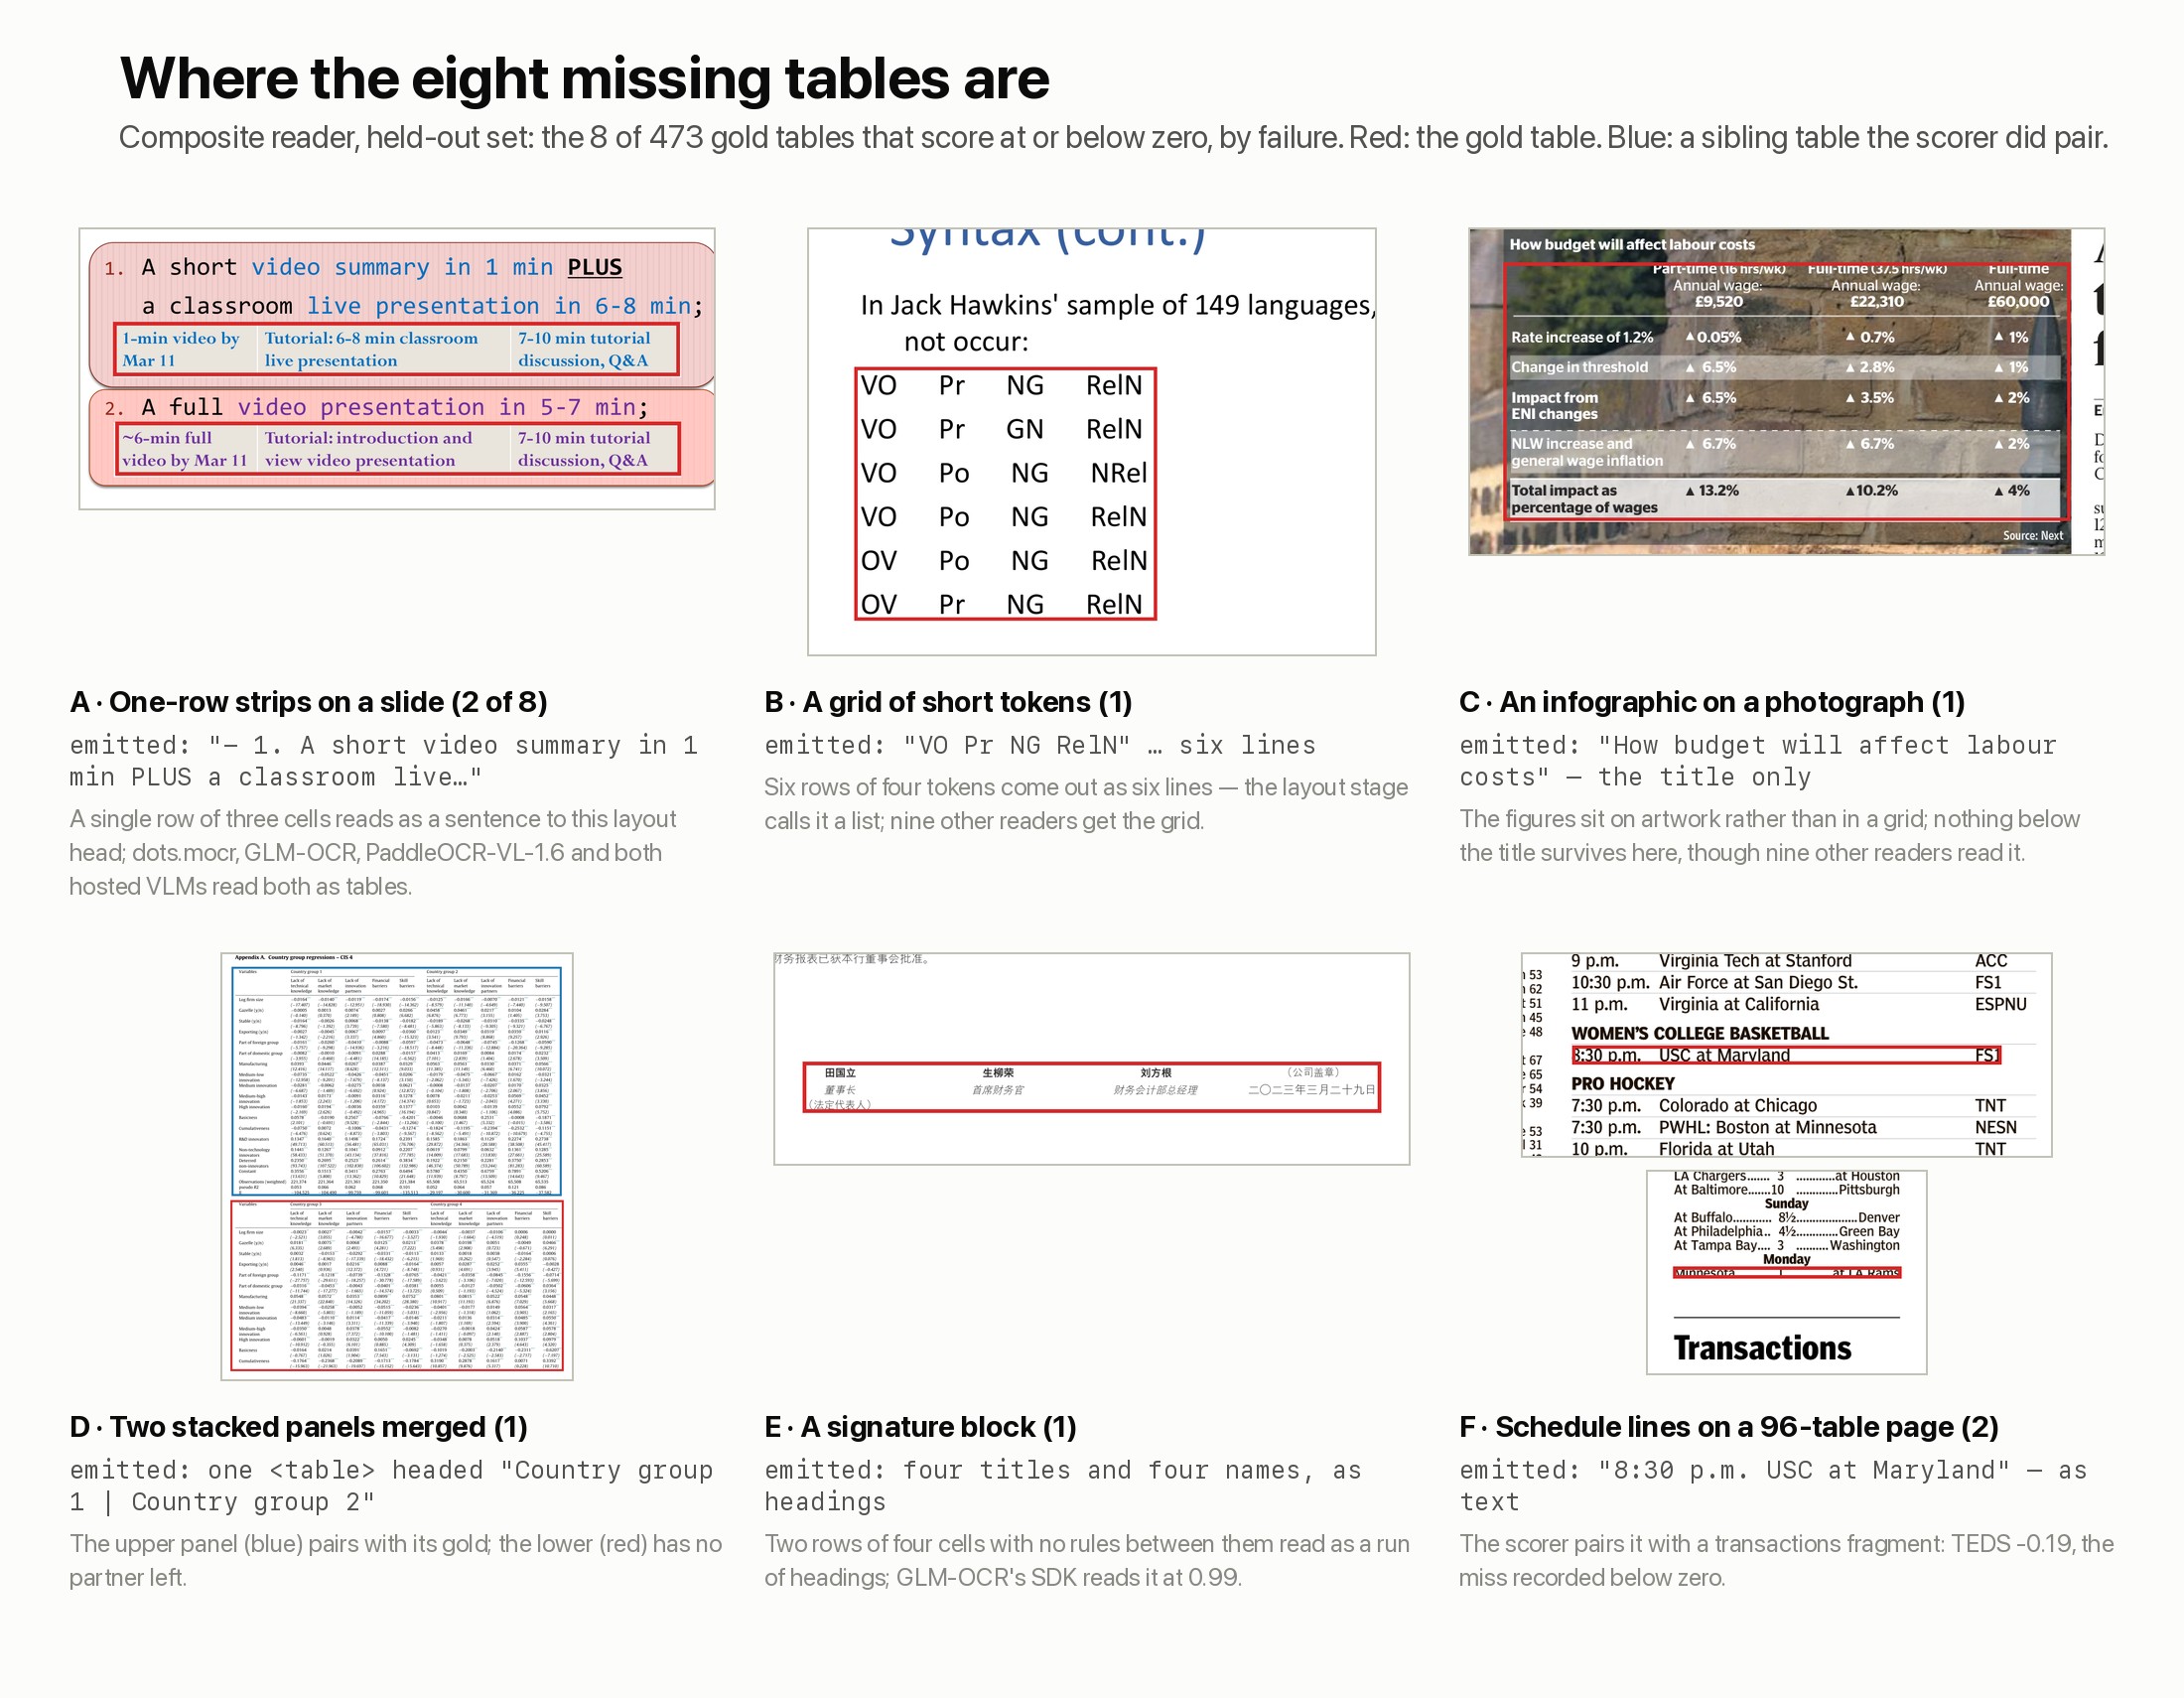
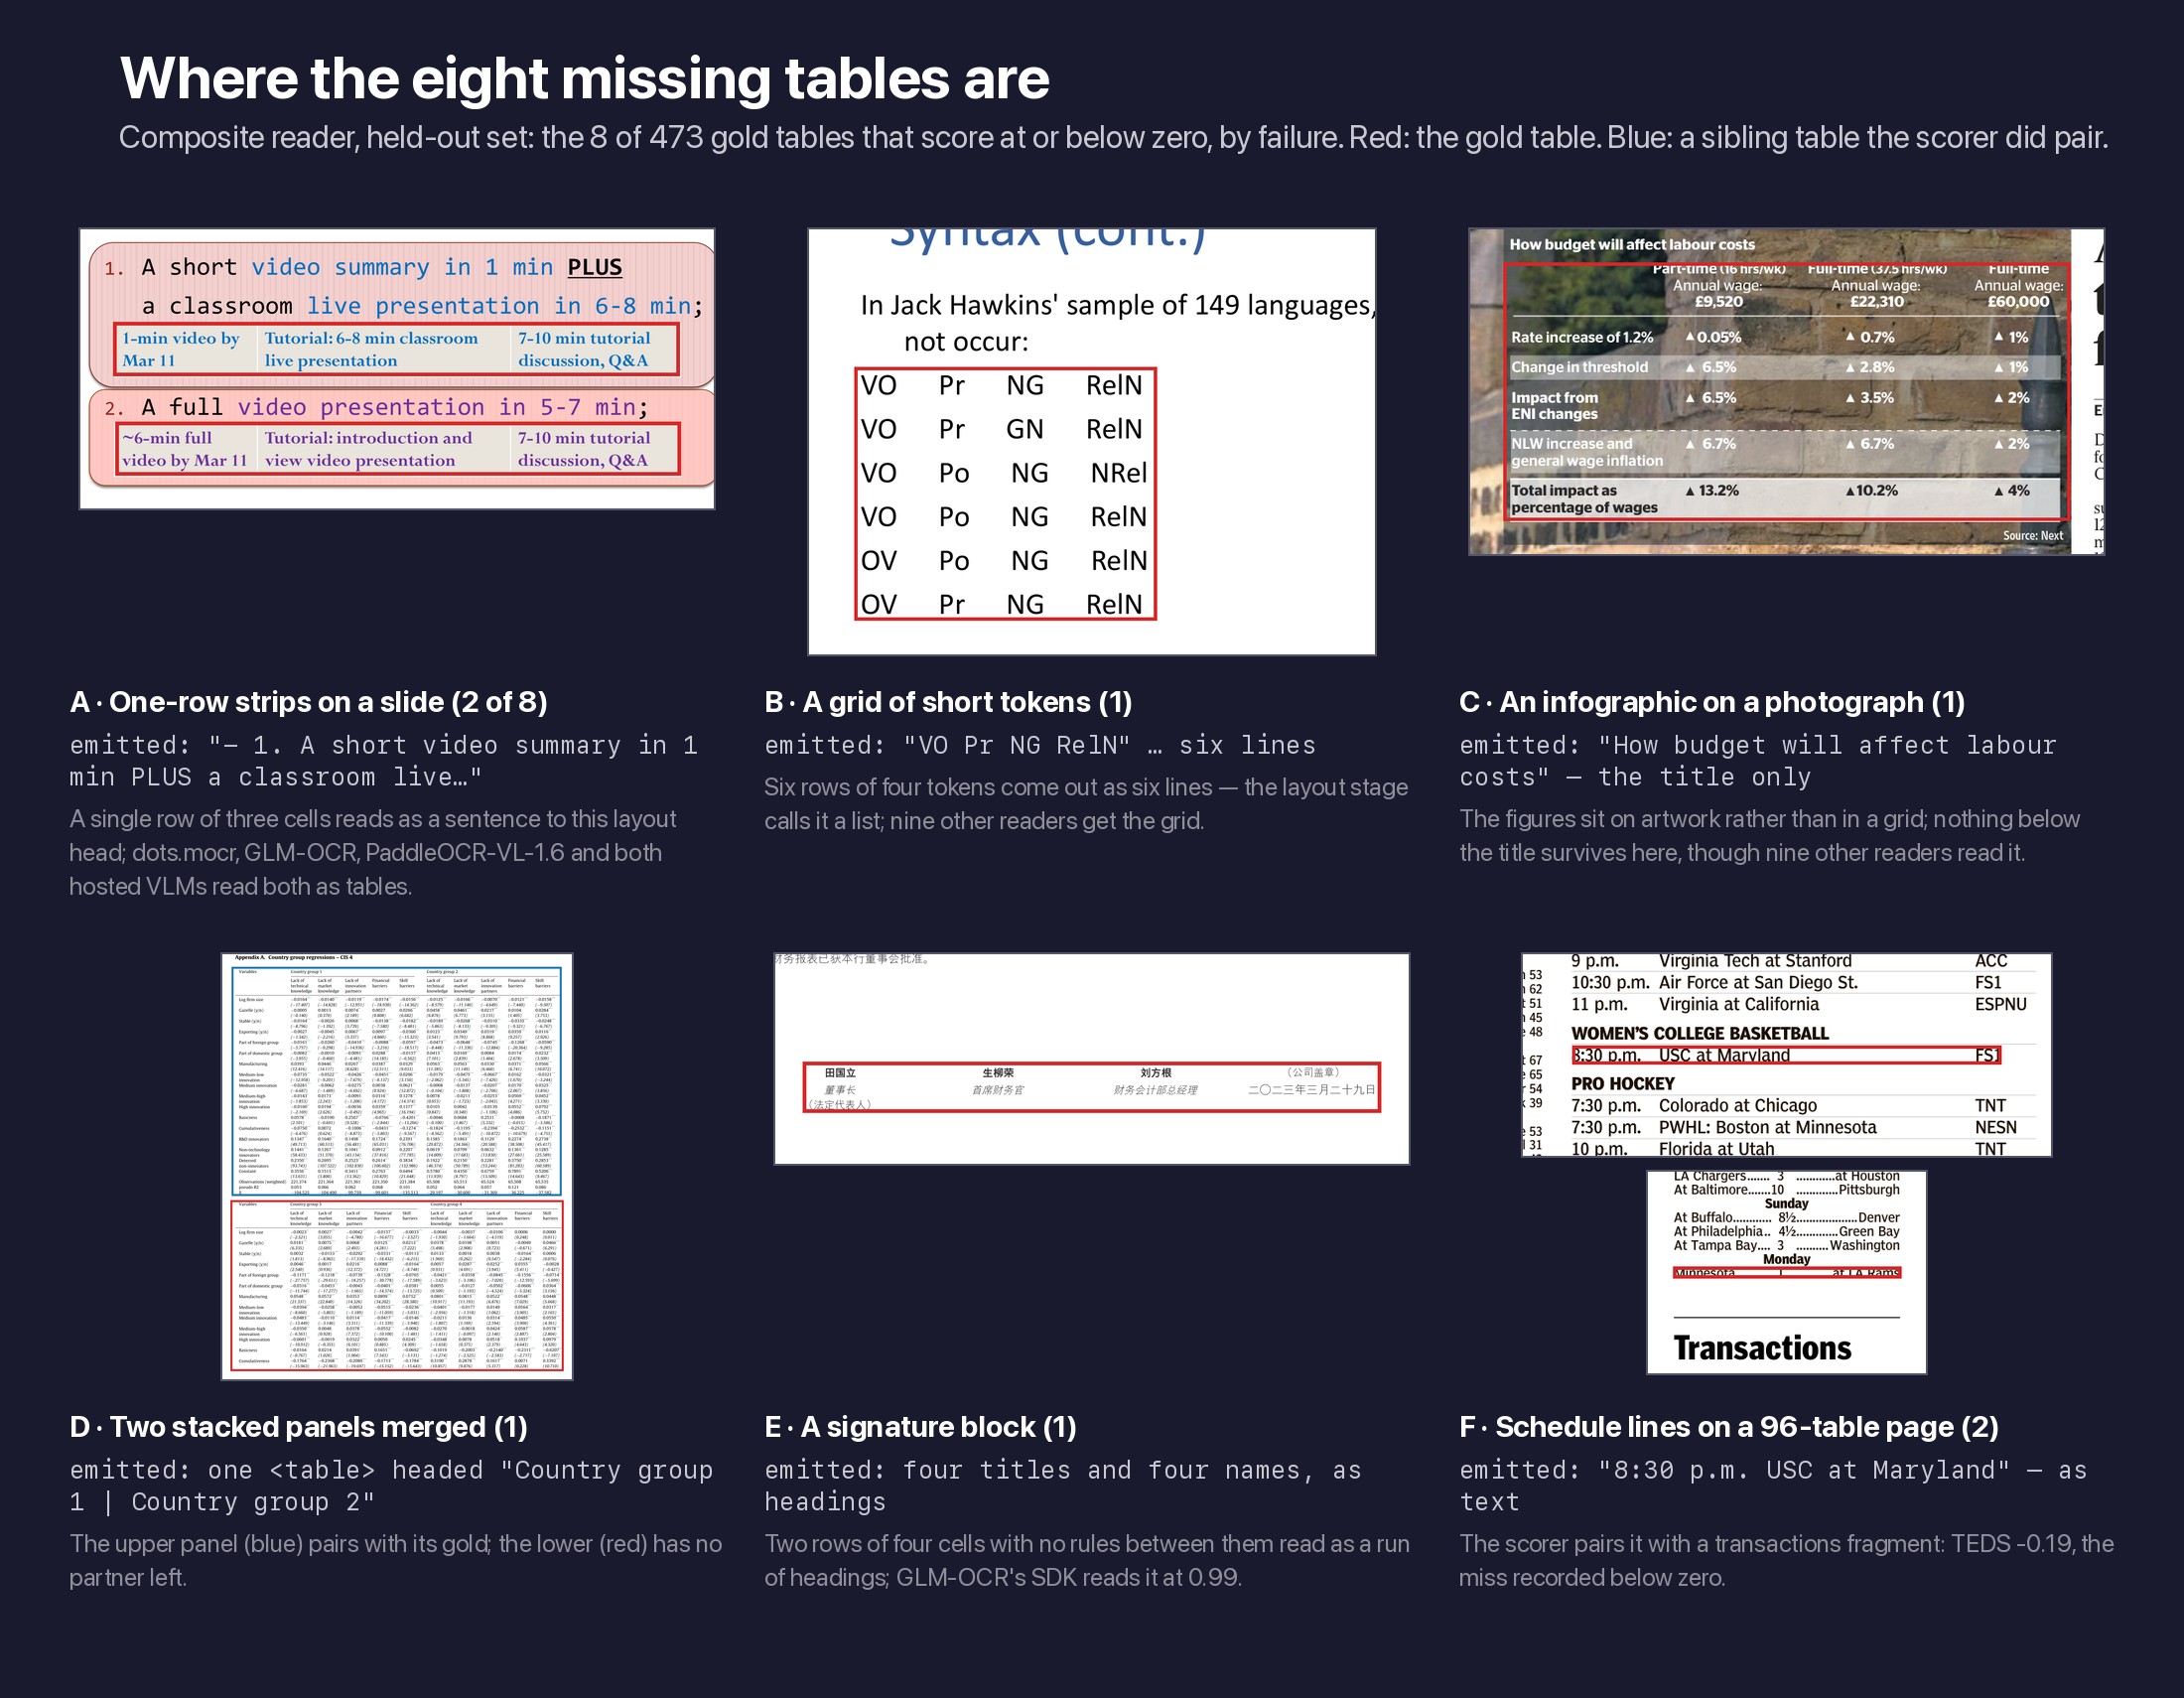
最好的那個 Reader 漏掉的八張表格,全部是偵測失敗,分成五種形狀(圖四):四張只有一列、被當成文字寫出來的表格,一個被當成清單的短詞方格,一張印在照片上的資訊圖表,兩個上下疊放的面板裡下面那個被併進上面,以及一個被讀成標題的簽章欄。這是這顆 layout 頭的盲點,不是整個領域:RapidAI 的 layout 階段八張全找得到,而且每一張都有某個 Reader 讀得出來。
誰掌控你的系統在讀什麼?
回頭看上面每一個具體發現需要什麼才找得到。Apple Vision 的缺陷是版面而不是字元辨識、Unlimited-OCR 的文字平均其實是在數它放棄了幾頁、最好的 Reader 漏掉的表格全部是偵測失敗,這些沒有一項在分數裡看得見。它們是把一頁一頁的原稿和一份一份的輸出擺在一起讀出來的。分數只告訴你某個 Reader 比較差;只有輸出會告訴你你會丟掉哪些頁,而那才決定一個 Reader 在你的資料上能不能用。
Reader 在系統所有相依裡還有一個特別之處:它的失敗會被寫下來。API 呼叫失敗會重試,Reader 讀壞的結果則被永久保存。chunk 進了 index,index 之後服務每一次查詢,過程中不會有任何錯誤,因為攪爛的表格照樣 embed 得起來,和乾淨的沒兩樣。等到有人發現,損害已經是一整批安靜的錯答案,而原因是幾個月前沒有人看過的一頁。所以「有回應」從來不是「這份文件被讀對了」的證據,而能回頭查證這件事,在這裡比在多數地方都值錢。
這件事指向的作法很具體:把原始文件留著、用自己的資料而不是公開資料建一份評測集,並且把每一次存下來的解析結果綁定到產生它的 parser build,因為「用哪個 parser」並不是一份 chunk 的完整描述。然後留一條換第二個 Reader 的路,以及一條把壞解析重建回來的路,因為這兩件事你遲早都會用到。我量過一個雲端模型,它的文字比我自己跑的任何東西都好,所以這不是在主張本機比較準;這是在主張把評測和復原留在自己手上,而一個你沒辦法釘在某個 build 上的模型,正是最需要這件事的情況。
重點整理
- Reader 是根本,之後的每一步都補不回來。 RAG pipeline 或 agent 的每一站都作用在 Reader 的輸出上,沒有一站看得到原本那一頁。讀錯的數字就是另一個數字;失去結構的表格,再大的模型也重建不回來。壞 Reader 唯一的解,是換一個更好的 Reader。
- 要引用 held-out 的數字,而且樣本要大到撐得住。 隨手挑 64 頁,表格密度會是整個 benchmark 的四倍,算出來的表格分數會往某個方法剛好的弱點方向偏掉十幾分。
- 雲端 frontier 模型的文字比這裡每個專家都好,表格卻漏掉三倍。 GPT-6 Astra 在文字和閱讀順序上都贏 composite,九種來源裡贏了五種,卻有 23 張表格從來沒找到,composite 是 8 張,而兩者都找到的表格,分數一模一樣。領先來自解析度和整頁一次讀完,不是推理。Claude Fable 5.1 在它接受的頁面上與 composite 平手,但直接拒讀十二頁,那是本機 Reader 沒有的失敗模式。
- 你 Mac 裡的免費 OCR,差的只是一個欄位偵測器。 字元辨識在作業系統裡已經解決了,版面沒有。餵它單欄的企業文件,它很好;餵它一份報紙,五分之二的字元會是錯的。
- 看表格分數之前,先把偵測和轉寫拆開。 「TEDS 51 分」和「找到的表格轉寫到 78 分,但漏掉三分之一」是同一個數字,而只有後者告訴你要修什麼。公式也是同一個拆法:寫錯 LaTeX 的 Reader 和根本不寫的 Reader,在編輯距離上長得一樣,要的解法卻完全不同。
- 專家需要它的 pipeline,通用模型不需要。 這裡每一個守得住結構的 OCR 專用模型,前面都掛著一個 layout 模型,而在一個 32 MB 的辨識器前面加上 layout 階段,值 77 個 TEDS 分。而且那些階段必須是學出來的:唯一用規則組起來的 pipeline 找得到欄位,讀起來卻跟免費 OCR 差不多。不管 README 怎麼寫,專家就是一條 pipeline;通用模型則是一個 prompt。
- 把 Reader 這一步掌握在自己手上。 Reader 讀壞的結果不會失敗,它會被 index 起來,然後在那裡繼續回答問題。留著原始檔、用自己的資料建評測集、把每一次存下的解析綁定到產生它的 parser build,並且挑一個你能檢查、能替換、能重跑的 Reader。