OCR 分數之外:文件 parser 真正失敗的地方
2026 年 10 月 4 日
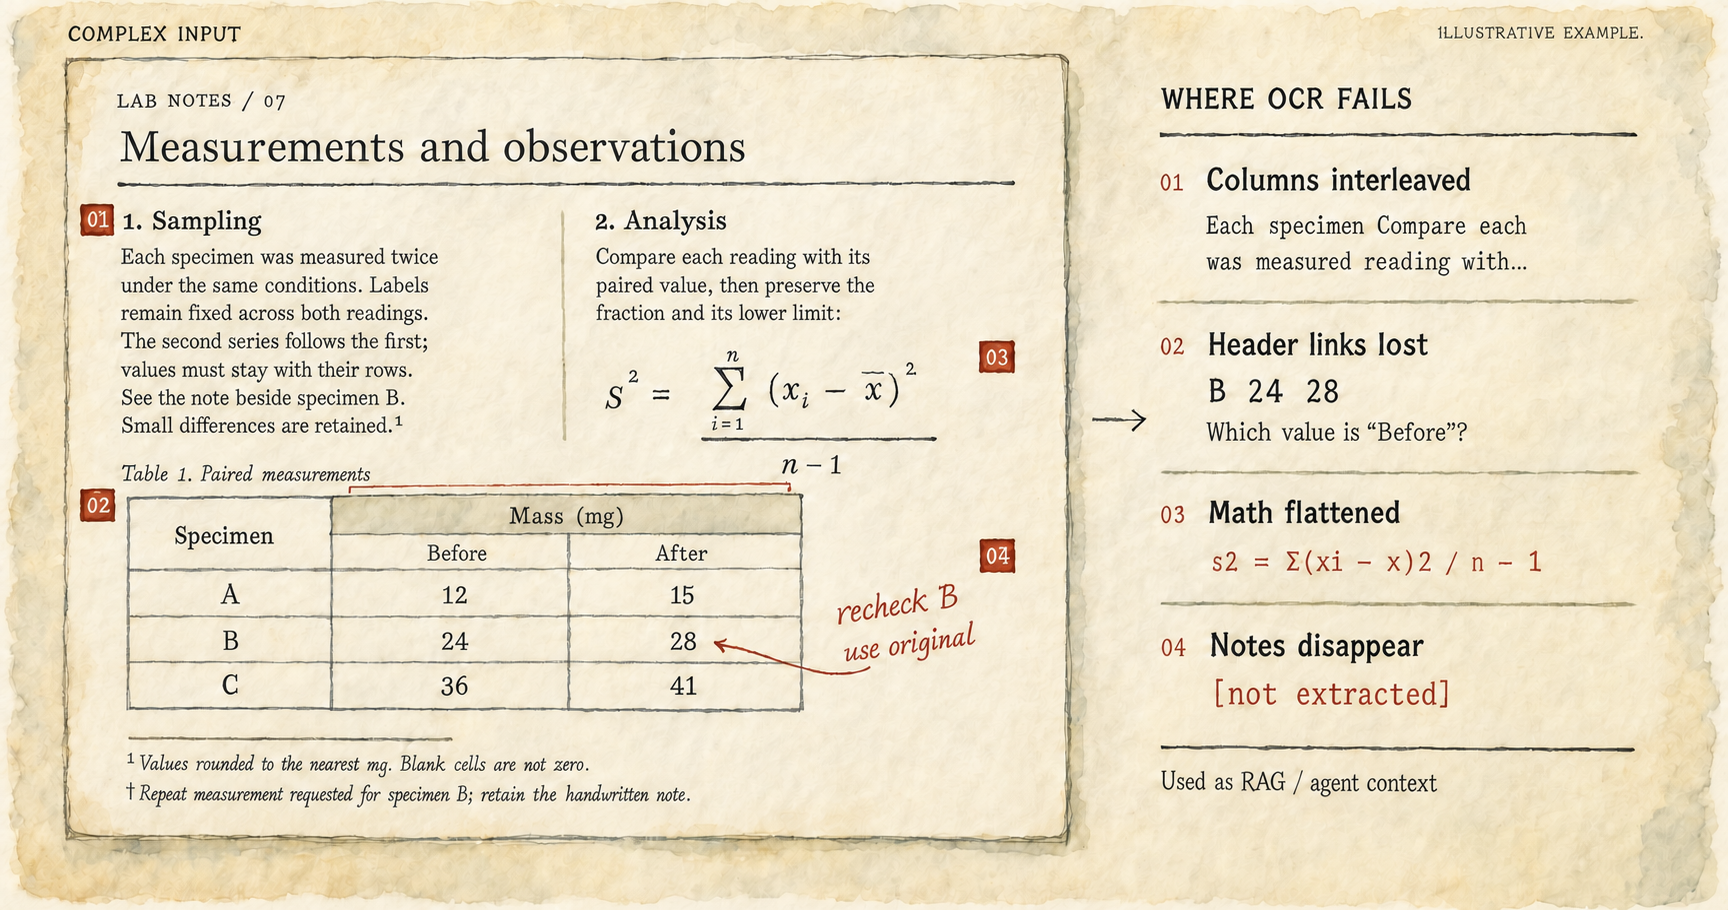
用 1,250 頁沒有調校過的 held-out 頁面,把十二個 Reader 各自用作者自己的協定跑一遍:MinerU2.5-Pro + dots.mocr 的 composite、OCR 專用模型、open-weights VLM、兩個雲端 frontier 模型,以及每台 Mac 內建的免費 OCR。重點不是誰的平均分數漂亮,而是你的系統會在哪些頁面上直接失去資料。
OCR 分數之外:文件 parser 真正失敗的地方
2026 年 10 月 4 日
用 1,250 頁沒有調校過的 held-out 頁面,把十二個 Reader 各自用作者自己的協定跑一遍:MinerU2.5-Pro + dots.mocr 的 composite、OCR 專用模型、open-weights VLM、兩個雲端 frontier 模型,以及每台 Mac 內建的免費 OCR。重點不是誰的平均分數漂亮,而是你的系統會在哪些頁面上直接失去資料。
Collection Autofill 的規模化架構
2026 年 5 月 28 日
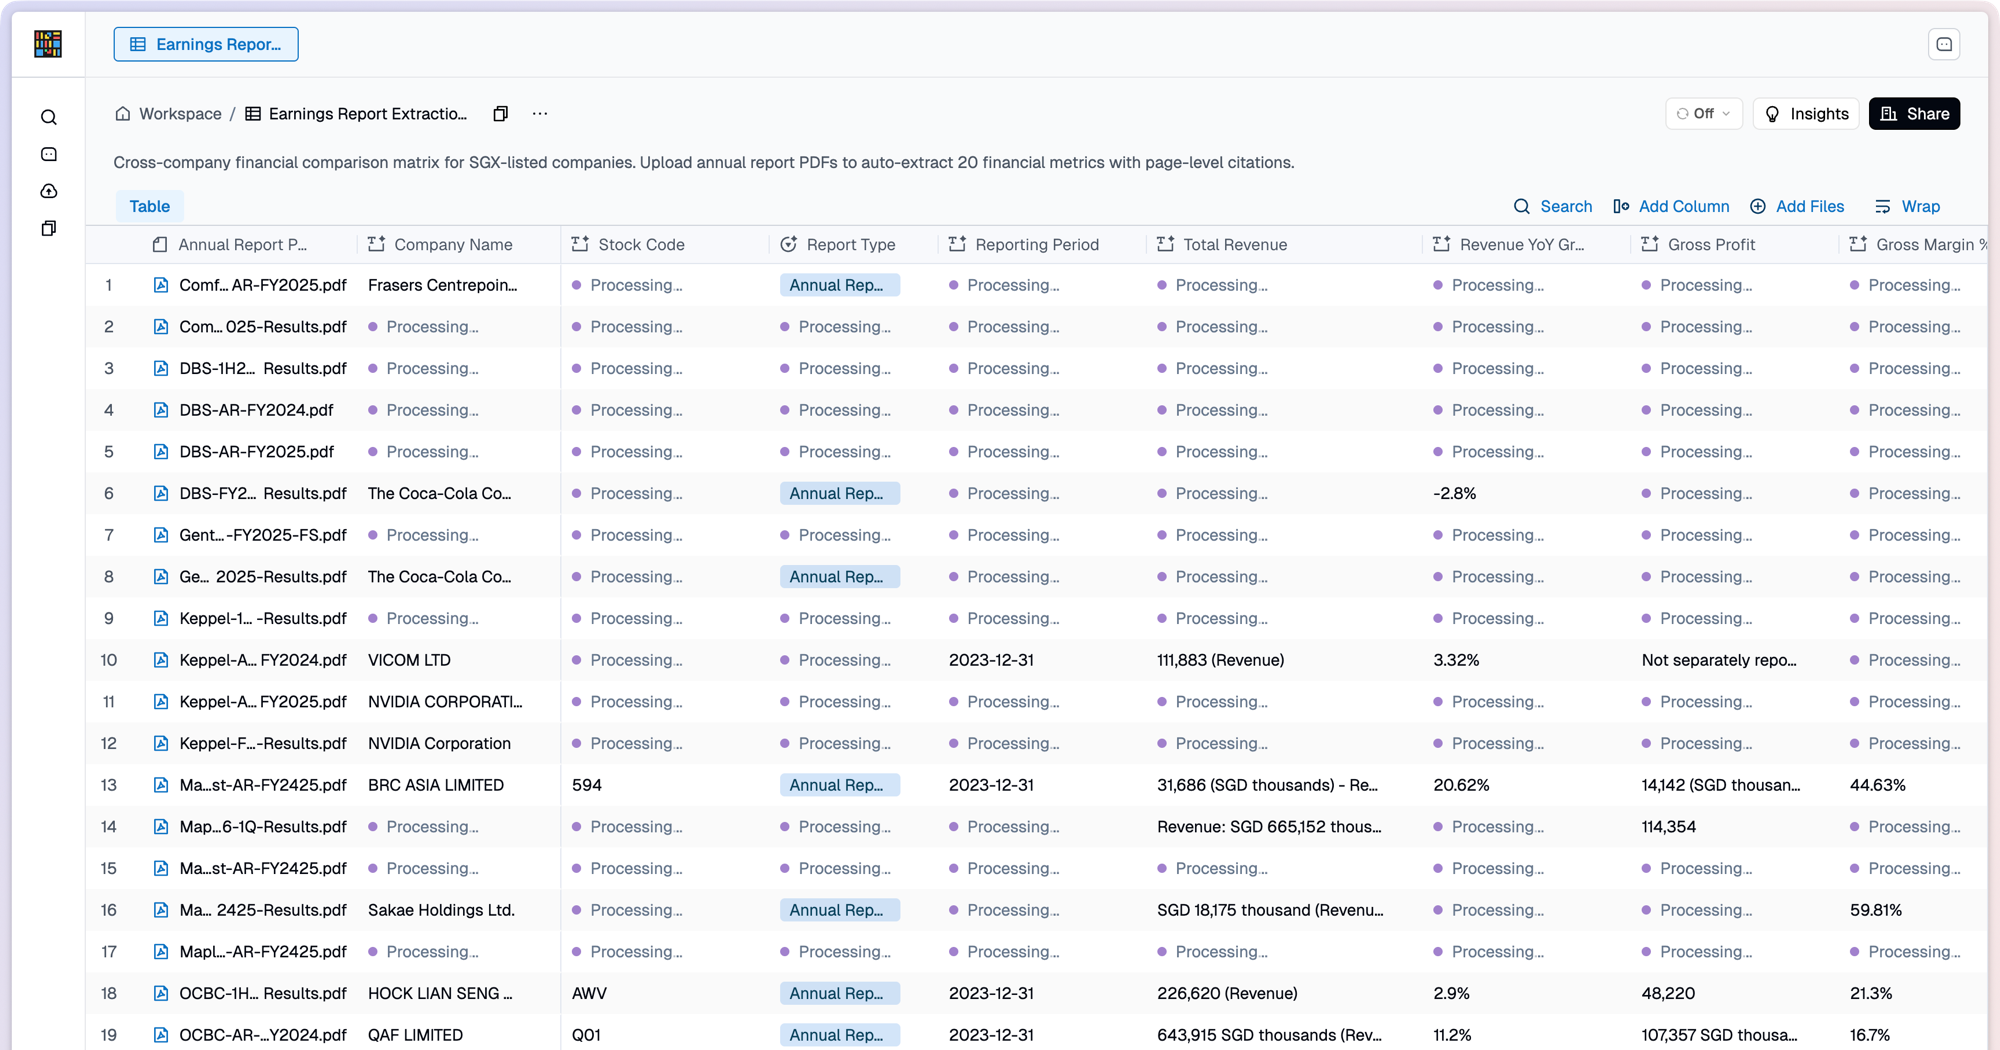
這篇文章談的是 Collection Autofill 的架構設計:一個把非結構化資料整理成 structured context 的產品介面,如何在幾百列到上千萬個 AI-computed cells 的規模下,仍然保持快速、公平且可觀測。
優化 Transformer 模型服務參數 – Apple Silicon GPU 的案例
2026 年 7 月 11 日
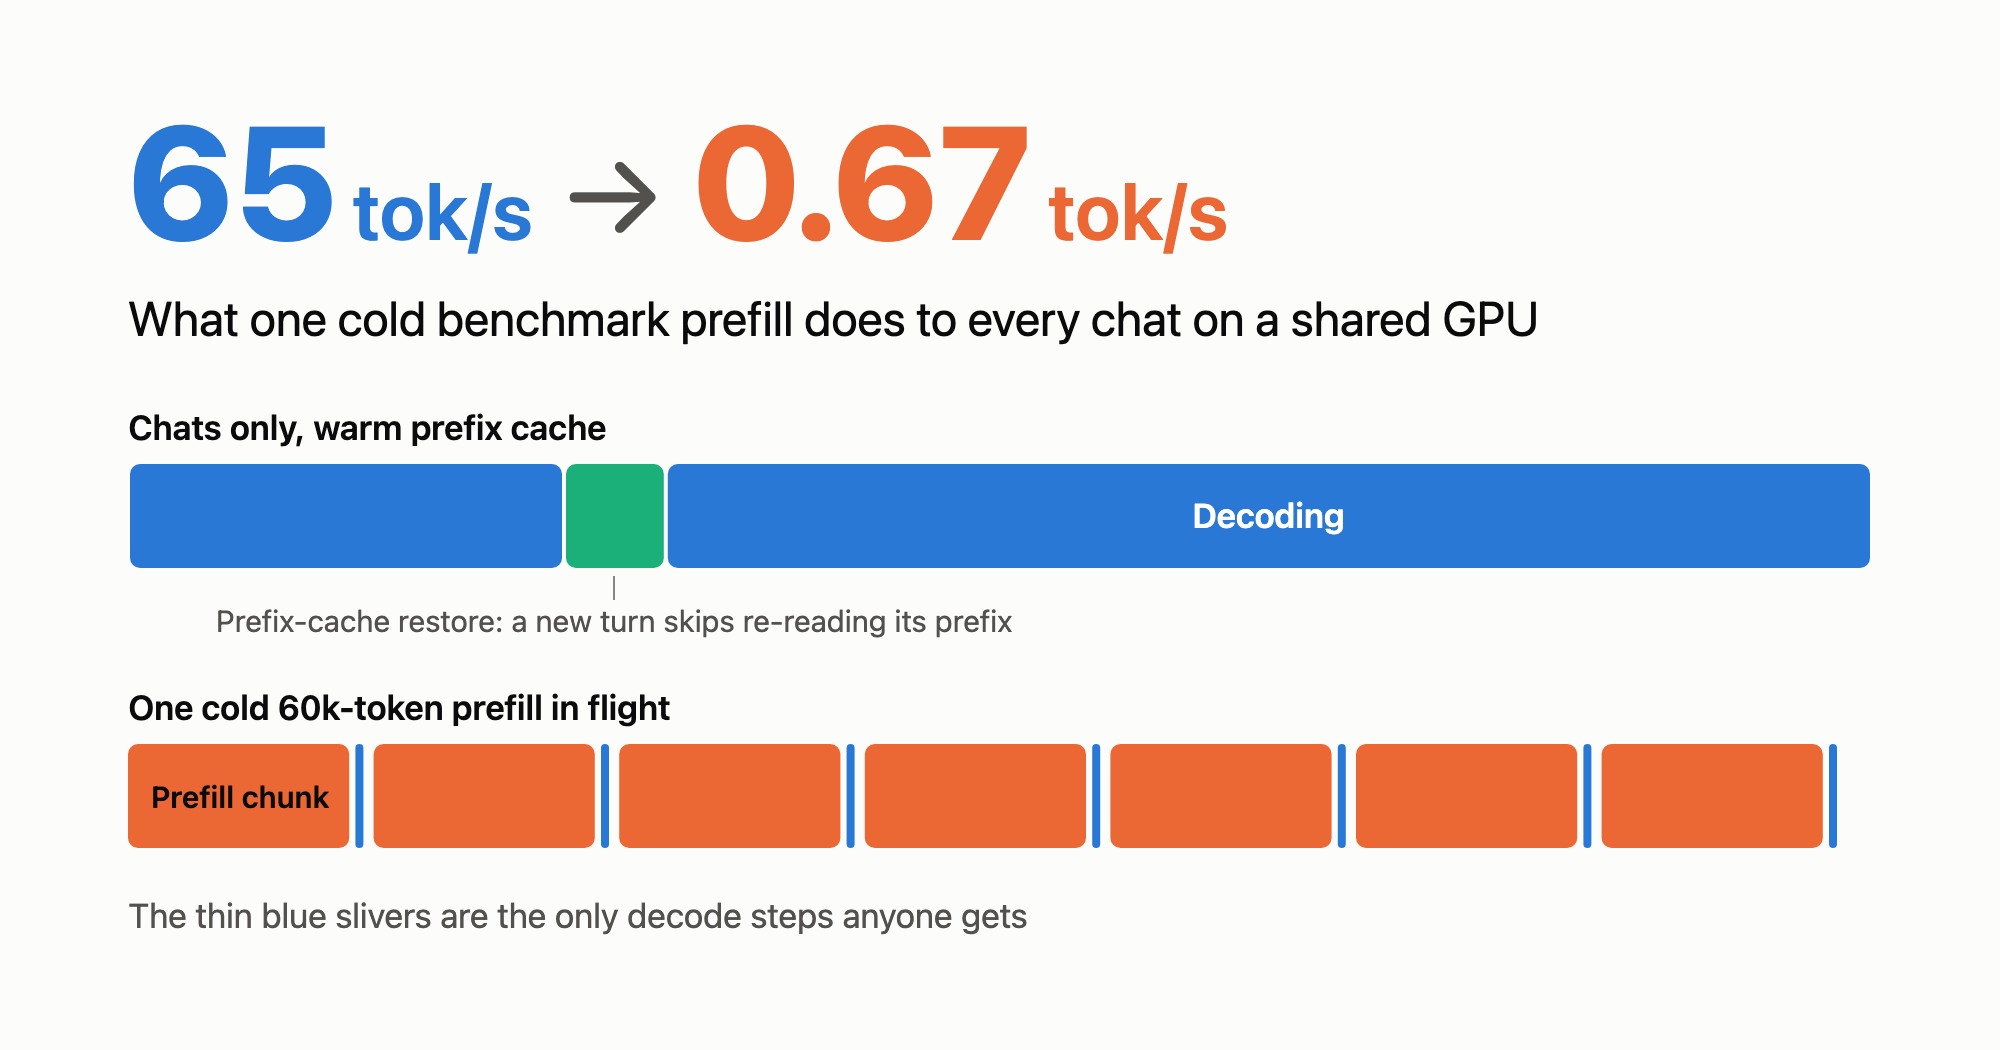
一台 MacBook Pro M4 Max、一個開源 MoE 模型,針對推論優化的一次實戰:為什麼讓 LLM 吞吐量崩跌 100 倍的是 prefill(而不是 decode),以及兩個 prefill 側的關鍵優化。